Agentic AI is zo goed als het datafundament eronder
Hoe autonomer AI-agents worden, hoe belangrijker identiteit, betrouwbare data en context worden. Waarom een AI-strategie zonder datastrategie onvolledig is.
De afgelopen tijd is er binnen bedrijven ongelooflijk veel aandacht gegaan naar agentic AI. Organisaties bouwen AI-agents, modelleren processen opnieuw, koppelen systemen aan elkaar en onderzoeken welke werkzaamheden straks gedeeltelijk of volledig door AI kunnen worden uitgevoerd. De nadruk ligt daarbij vooral op maken en experimenteren. Er wordt gebouwd, getest, aangepast en opnieuw gebouwd.
Dat is op zichzelf logisch. De mogelijkheden van agentic AI zijn groot en de technologie ontwikkelt zich razendsnel. Tegelijkertijd ontstaat er hierdoor een risico dat een veel minder sexy, maar minstens zo belangrijk onderwerp naar de achtergrond verdwijnt: het datafundament waarop al die AI moet functioneren.
Want hoe goed een AI-agent ook is, uiteindelijk moet die agent zijn informatie ergens vandaan halen. Als de onderliggende data niet klopt, verspreid staat over tientallen systemen of niet eenduidig aan dezelfde klant kan worden gekoppeld, ontstaat er een fundamenteel probleem. Je kunt dan een bijzonder intelligente agent bouwen, maar die agent opereert nog steeds boven op een gefragmenteerde werkelijkheid.
Garbage in, garbage out is niet langer het hele verhaal
Het principe van garbage in, garbage out kennen we al decennialang. Stop je slechte informatie in een systeem, dan kun je moeilijk verwachten dat er betrouwbare resultaten uitkomen.
Bij agentic AI gaat het probleem alleen verder dan dat. Het draait niet meer uitsluitend om de vraag of afzonderlijke gegevens correct zijn. Steeds belangrijker wordt de vraag hoe data uit verschillende delen van de organisatie bij elkaar wordt gebracht en hoe een AI-agent kan begrijpen welke informatie bij elkaar hoort.
Veel organisaties hebben bijvoorbeeld meerdere databases waarin gegevens over dezelfde klant voorkomen. In het CRM heeft iemand een klantnummer, in het marketingplatform wordt die persoon herkend aan een e-mailadres en in het facturatiesysteem bestaat weer een ander accountnummer. In het klantenserviceplatform staat misschien nog een oud telefoonnummer, terwijl het e-commerceplatform juist de meest actuele contactgegevens bevat.
De data hoeft op zichzelf niet eens verkeerd te zijn. Het probleem is dat niemand, en daarmee ook de AI-agent niet, automatisch weet dat al die records over dezelfde persoon gaan.
Precies daar wordt het datafundament cruciaal.
De belangrijkste vraag is steeds vaker: over wie hebben we het eigenlijk?
Als organisaties serieus met agentic AI aan de slag gaan, verandert de manier waarop ze naar data moeten kijken. Het gaat niet alleen meer om de vraag welke informatie beschikbaar is, maar vooral om de vraag wie of wat achter die informatie zit.
Stel dat een klant contact opneemt met een organisatie. Een AI-agent moet dan kunnen bepalen wie die klant is, welke producten hij gebruikt, welke eerdere contacten er zijn geweest, welke afspraken met hem zijn gemaakt en welke informatie op dit moment actueel is.
Dat klinkt eenvoudig, maar binnen veel organisaties is dat allesbehalve vanzelfsprekend.
De ene afdeling werkt met een CRM, een andere met een ERP-systeem en weer een andere met een eigen serviceplatform. Daarnaast bestaan er datawarehouses, marketingtools, e-commerceplatformen, documentmanagementsystemen en soms nog allerlei lokale databases of Excelbestanden.
Al die systemen bevatten stukjes van dezelfde werkelijkheid.
Een medewerker die al tien jaar bij een organisatie werkt, weet vaak precies waar hij moet kijken. Die weet dat adresgegevens in systeem A meestal betrouwbaar zijn, dat contractinformatie uit systeem B moet komen en dat de informatie in systeem C regelmatig achterloopt.
Een AI-agent heeft die impliciete kennis niet vanzelf.
Je moet die kennis expliciet maken.
Eén klant kan in een organisatie tien verschillende identiteiten hebben
Dat maakt identity resolution een steeds belangrijker onderdeel van het datafundament voor agentic AI. Identity resolution draait in essentie om één vraag: welke records, accounts en identifiers horen daadwerkelijk bij dezelfde persoon of organisatie?
Een klant kan bijvoorbeeld in het ene systeem geregistreerd staan met een privé-mailadres en in een ander systeem met een zakelijk e-mailadres. Misschien is er daarnaast een telefoonnummer, een klantnummer en een gebruikersaccount. Wanneer die verschillende identifiers niet goed aan elkaar zijn gekoppeld, kan een AI-agent denken dat hij met meerdere personen te maken heeft.
Het tegenovergestelde probleem kan natuurlijk ook ontstaan. Twee personen kunnen eenzelfde adres gebruiken of een gedeeld e-mailadres hebben, waardoor een systeem ten onrechte concludeert dat zij dezelfde persoon zijn.
Dit soort problemen bestonden al voordat generatieve AI populair werd. Het verschil is dat de consequenties groter worden wanneer AI niet alleen informatie presenteert, maar ook zelfstandig acties gaat uitvoeren.
Als een medewerker verschillende records te zien krijgt, kan hij zelf nog twijfelen, controleren en corrigeren. Een autonome agent moet op enig moment een beslissing nemen.
Hoe autonomer AI wordt, hoe belangrijker betrouwbare identificatie dus wordt.
Customer 360 krijgt door agentic AI een nieuwe betekenis
Ook het idee van Customer 360 is niet nieuw. Organisaties proberen al jaren een zo volledig mogelijk beeld van hun klanten op te bouwen door data uit verschillende bronnen met elkaar te combineren.
Lange tijd werd Customer 360 vooral gezien als een middel voor marketing, personalisatie en analytics. Als je een beter beeld van de klant had, kon je relevantere campagnes maken en betere segmentaties uitvoeren.
Door agentic AI verandert dat.
Een totaalbeeld van de klant wordt steeds meer onderdeel van de operationele infrastructuur van een organisatie. Wanneer een AI-agent namens een bedrijf met een klant communiceert, een probleem oplost of een beslissing voorbereidt, moet die agent kunnen begrijpen wie hij voor zich heeft.
Daarbij is niet alleen historische informatie belangrijk. Ook context speelt een rol. Welke producten gebruikt deze klant? Welke servicevragen heeft hij eerder gesteld? Is er al een klacht in behandeling? Is er gisteren misschien al contact geweest met een medewerker? Zijn er afspraken gemaakt waarvan de agent op de hoogte moet zijn?
Zonder die samenhang ontstaat een situatie waarin een agent technisch gezien heel intelligent kan zijn, maar organisatorisch behoorlijk dom opereert.
Data orchestration wordt daardoor belangrijker dan ooit
Daarom wordt naast datakwaliteit ook data orchestration steeds belangrijker.
Data orchestration draait om het organiseren, verbinden en op het juiste moment beschikbaar maken van data uit verschillende systemen. In plaats van informatie alleen op te slaan, moet een organisatie steeds beter kunnen bepalen welke data in welke situatie nodig is en hoe die data veilig en betrouwbaar bij elkaar kan worden gebracht.
Dat betekent overigens niet automatisch dat alle informatie in één gigantische centrale database moet worden geplaatst.
Juist agentic AI maakt een andere manier van werken mogelijk.
Een agent kan op het moment dat informatie nodig is verschillende systemen raadplegen, gegevens verzamelen en daar tijdelijk een compleet beeld van maken. De agent hoeft daarvoor niet noodzakelijk alle data permanent naar één centraal platform te verplaatsen.
Dat kan een fundamentele verandering betekenen in de manier waarop organisaties hun data-architectuur ontwerpen.
Waar organisaties traditioneel vaak probeerden om eerst alle informatie op één plek te krijgen, kan het in een agentic architectuur veel meer draaien om het dynamisch samenstellen van context.
De agent als intelligente octopus
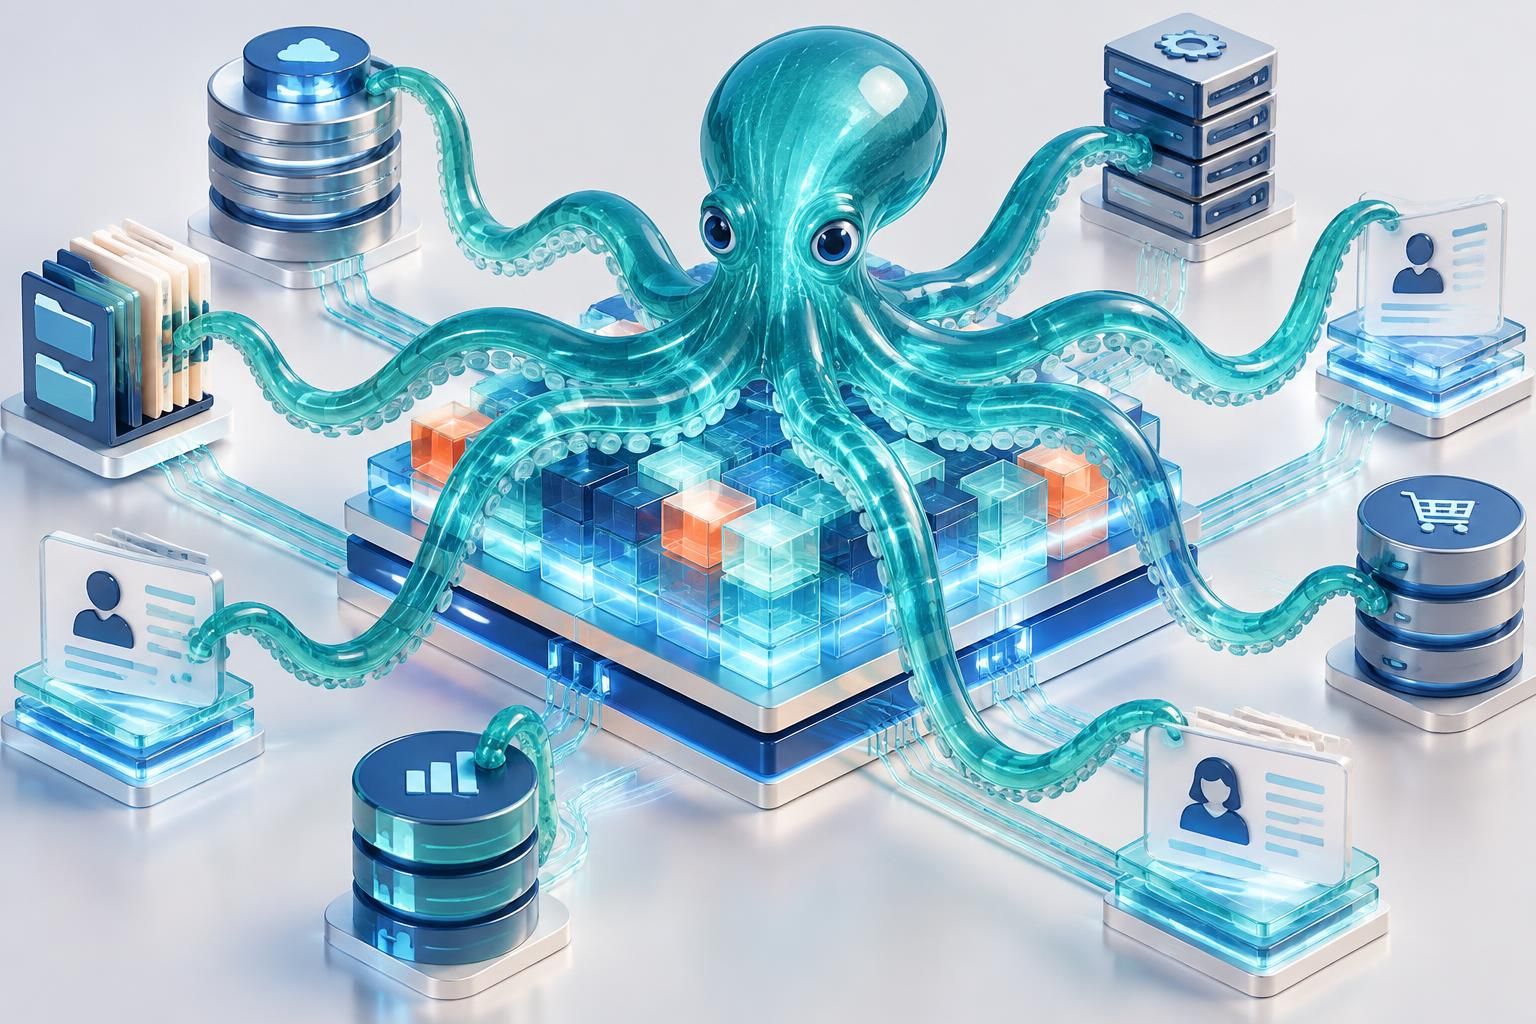
Je kunt een AI-agent in dat opzicht vergelijken met een intelligente octopus.
De verschillende tentakels van die octopus kunnen verbinding maken met verschillende systemen binnen de organisatie. Eén tentakel haalt klantgegevens uit het CRM, een andere kijkt naar recente facturen, een derde haalt de meest recente servicemeldingen op en weer een andere controleert contractinformatie.
Vervolgens brengt de agent al die informatie bij elkaar en probeert hij er één coherent beeld van te maken.
Dat is precies waarom agentic AI niet alleen afhankelijk hoeft te zijn van een sterk datafundament, maar tegelijkertijd ook een rol kan spelen bij het beter benutten van bestaande data.
Een agent kan bijvoorbeeld herkennen dat gegevens uit verschillende systemen waarschijnlijk bij dezelfde klant horen. Hij kan afwijkingen signaleren, ontbrekende informatie herkennen en verschillende bronnen naast elkaar leggen.
Daarmee wordt de agent niet alleen een gebruiker van data, maar ook een orchestrator van data.
En juist dat maakt agentic AI interessant.
Van één centrale database naar dynamische context
Jarenlang lag binnen data-architectuur veel nadruk op centralisatie. Organisaties bouwden datawarehouses, data lakes, lakehouses en customer data platforms met het idee dat zoveel mogelijk informatie naar één centrale plek moest worden gebracht.
Dat model blijft in veel gevallen waardevol, maar agentic AI maakt ook een andere architectuur mogelijk.
Niet alle informatie hoeft noodzakelijk fysiek op dezelfde plek te staan, zolang een agent betrouwbaar kan bepalen waar de juiste informatie te vinden is en hoe die gecombineerd moet worden.
Dat verschuift de aandacht van statische data naar dynamische context.
Een AI-agent hoeft bijvoorbeeld niet de volledige klantdatabase te kennen. Hij moet op het juiste moment kunnen vaststellen welke informatie relevant is voor deze specifieke klant, in deze specifieke situatie en voor deze specifieke taak.
Dat is een veel contextuelere manier van werken.
De vraag verandert daardoor van: “Waar slaan we alle data op?” naar: “Hoe zorgen we ervoor dat een agent op ieder moment de juiste context kan samenstellen?”
Dat lijkt misschien een subtiel verschil, maar architectonisch is het een enorme verschuiving.
Toch kan AI niet zelf bepalen wat de waarheid is
Daar zit ook direct de grens.
AI kan heel goed patronen herkennen. Een agent kan zien dat twee namen sterk op elkaar lijken, dat twee records hetzelfde telefoonnummer bevatten of dat verschillende accounts waarschijnlijk bij dezelfde organisatie horen.
Maar uiteindelijk moet een bedrijf nog steeds bepalen wanneer iets als waarheid wordt beschouwd.
Welke bron is bijvoorbeeld leidend wanneer twee systemen een ander adres tonen? Wat gebeurt er als het CRM zegt dat een klant actief is, terwijl het facturatiesysteem laat zien dat het contract drie maanden geleden is beëindigd? Welke informatie mag automatisch worden samengevoegd en wanneer is menselijke controle nodig?
Dat soort vragen kunnen niet volledig aan een taalmodel worden overgelaten.
Een organisatie moet zelf bepalen welke systemen leidend zijn, welke gegevens mogen worden gebruikt, welke regels gelden bij conflicten en hoe besluiten achteraf kunnen worden gecontroleerd.
Dat is data governance.
En juist in een wereld van agentic AI wordt goede governance steeds belangrijker.
Een goed datafundament gaat daarom veel verder dan schone databases
Wanneer mensen over een goed datafundament praten, denken ze vaak vooral aan datakwaliteit. Zijn de gegevens compleet? Zijn velden correct ingevuld? Zijn er geen dubbele records?
Dat blijft belangrijk, maar voor agentic AI is het slechts een deel van het verhaal.
Een goed datafundament betekent ook dat duidelijk is wie een klant is, welke identifiers bij hem horen en welke informatie uit verschillende systemen aan dezelfde persoon kan worden gekoppeld.
Daarnaast moet bekend zijn welke databron leidend is. Een organisatie moet bijvoorbeeld bepalen uit welk systeem een agent het officiële adres, de actuele contractstatus of de meest recente betaalinformatie moet halen.
Ook moet duidelijk zijn waar informatie vandaan komt. Wanneer een agent een beslissing neemt of een advies geeft, wil je kunnen begrijpen op basis van welke data dat is gebeurd.
Daar komt vervolgens nog autorisatie bij. Alleen omdat een agent technisch toegang kan krijgen tot informatie, betekent dat niet dat hij die informatie ook in iedere situatie mag gebruiken.
Een goed datafundament bestaat dus niet alleen uit data. Het bestaat uit identiteit, context, betrouwbaarheid, toegang, governance en herleidbaarheid.
Van single source of truth naar system of context
Organisaties spreken al jaren over het creëren van een single source of truth. Het idee is dat er voor belangrijke informatie één gezaghebbende bron bestaat.
Dat principe blijft waardevol, maar in de wereld van agentic AI is het mogelijk niet voldoende.
Een agent heeft vaak niet één waarheid nodig, maar een complete context.
Wanneer een klant contact opneemt, kan die context bestaan uit CRM-informatie, contractgegevens, recente transacties, eerdere communicatie, productgebruik en openstaande servicemeldingen.
Geen enkele bron bevat noodzakelijk het volledige verhaal.
Daarom ontstaat naast de single source of truth misschien een nieuw concept: het system of context.
Een infrastructuur die niet alleen bepaalt welke informatie waar staat, maar die op ieder moment de juiste context rondom een persoon, organisatie, proces of beslissing kan samenstellen.
Dat is waarschijnlijk een van de belangrijkste architectuurvraagstukken van agentic AI.
Waarom succesvolle AI-demo's soms vastlopen in de praktijk
Het belang van dat fundament wordt vaak pas zichtbaar wanneer een organisatie van een pilot naar productie probeert te gaan.
Een AI-demo is relatief eenvoudig te controleren. Je werkt met een duidelijke use case, een beperkte hoeveelheid data en een klein aantal systemen. De uitzonderingen zijn overzichtelijk en de context is vaak zorgvuldig voorbereid.
De werkelijkheid van een grote organisatie ziet er heel anders uit.
Daar bestaan dubbele klantrecords, verouderde gegevens, ontbrekende velden en verschillende definities van hetzelfde begrip. Er zijn legacy-systemen, historische databases, handmatige correcties en uitzonderingsprocessen die nergens formeel zijn vastgelegd.
Mensen hebben door de jaren heen geleerd hoe ze daarmee moeten omgaan.
Een AI-agent moet dat nog leren.
En precies daar blijkt vaak dat het probleem niet de intelligentie van het AI-model is, maar de kwaliteit en samenhang van de onderliggende organisatiegegevens.
De volgende fase van agentic AI draait om vertrouwen
De eerste fase van generatieve AI draaide vooral om verwondering. Mensen ontdekten dat AI kon schrijven, programmeren, samenvatten en analyseren.
De volgende fase ging over toepassing. Bedrijven gingen copilots bouwen, processen automatiseren en AI integreren in bestaande software.
Met agentic AI komen we nu in een volgende fase terecht.
Daarin draait het steeds minder om de vraag of AI iets kan en steeds meer om de vraag of we erop kunnen vertrouwen dat AI iets zelfstandig doet.
Dat verschil is enorm.
Wanneer een AI-systeem alleen een concepttekst genereert, blijft de gebruiker verantwoordelijk voor de uiteindelijke beslissing.
Wanneer een AI-agent zelfstandig een order wijzigt, een klant antwoord geeft, een dossier verwerkt of een betaling voorbereidt, wordt de kwaliteit van de onderliggende informatie ineens bedrijfskritisch.
Hoe autonomer de agent wordt, hoe belangrijker het datafundament.
AI-strategie zonder datastrategie is daarom onvolledig
Veel organisaties hebben inmiddels een AI-strategie. Ze maken roadmaps, selecteren use cases, experimenteren met modellen en bouwen platformen waarop verschillende agents kunnen draaien.
Maar naast iedere AI-roadmap zou eigenlijk een data-roadmap moeten liggen.
Niet alleen met de vraag hoeveel data er beschikbaar is, maar vooral met de vraag of een agent die data daadwerkelijk kan begrijpen en vertrouwen.
Kunnen we dezelfde klant herkennen wanneer hij in vijf systemen voorkomt? Weten we welke informatie leidend is als systemen elkaar tegenspreken? Kunnen we achterhalen waar gegevens vandaan komen? Is duidelijk welke data een agent in welke situatie mag gebruiken?
Dat zijn misschien minder spannende vragen dan het bouwen van een nieuwe AI-agent, maar ze bepalen uiteindelijk wel of zo'n agent betrouwbaar kan functioneren.
Misschien moeten we minder beginnen bij de agent
De verleiding is groot om voor ieder probleem direct een nieuwe agent te bouwen.
Een sales-agent, een service-agent, een marketing-agent, een finance-agent en een HR-agent. Iedere afdeling krijgt zijn eigen toepassingen en ieder team bouwt zijn eigen koppelingen met data.
Dat werkt misschien in de eerste experimenten, maar op termijn ontstaat dan een nieuw probleem.
Iedere agent moet opnieuw uitzoeken waar de juiste informatie staat, welke database leidend is en welke klantidentiteiten aan elkaar gekoppeld moeten worden.
Daarmee creëer je feitelijk een nieuwe vorm van technische schuld.
Het alternatief is om meer aandacht te besteden aan een gedeelde contextlaag waarop meerdere agents kunnen functioneren.
Een fundament waarin identiteit, databronnen, autorisaties en betrouwbaarheid al zijn geregeld en waarop verschillende AI-toepassingen kunnen voortbouwen.
Dat maakt nieuwe agents uiteindelijk niet alleen betrouwbaarder, maar waarschijnlijk ook veel sneller te ontwikkelen.
Hoe slimmer AI wordt, hoe belangrijker het fundament
Daar zit misschien wel de grootste paradox van agentic AI.
Hoe geavanceerder de technologie bovenin de organisatie wordt, hoe belangrijker de ogenschijnlijk traditionele disciplines daaronder worden.
Datamodellering, Master Data Management, identity resolution, metadata, data lineage, governance en security klinken misschien minder spectaculair dan autonomous agents en multi-agent systems.
Maar zonder die onderdelen blijft de intelligentie van AI begrensd door de chaos van de informatie waarop die AI moet werken.
Een agent kan namelijk ongelooflijk slim zijn en toch de verkeerde beslissing nemen wanneer hij de verkeerde klant voor zich heeft.
Hij kan perfect redeneren op basis van een contract dat inmiddels is verlopen.
Hij kan een uitstekend antwoord formuleren op basis van informatie die bij een andere persoon hoort.
Het model kan in al die gevallen precies doen waarvoor het is ontworpen.
Het probleem zit dan niet in de intelligentie.
Het probleem zit in het fundament.
De organisaties die winnen, bouwen daarom niet alleen AI-agents
De organisaties die de komende jaren het meeste uit agentic AI halen, zullen waarschijnlijk niet simpelweg de bedrijven zijn met de slimste modellen of de meeste agents.
Het zullen organisaties zijn die erin slagen AI te combineren met een betrouwbaar datafundament.
Organisaties die weten wie hun klanten zijn, ook wanneer die klanten verspreid over meerdere systemen voorkomen. Organisaties die weten welke bronnen betrouwbaar zijn en die context dynamisch kunnen samenstellen wanneer een agent die nodig heeft.
En organisaties die niet alleen nadenken over wat AI mag doen, maar ook over welke informatie AI daarvoor mag gebruiken en hoe beslissingen achteraf gecontroleerd kunnen worden.
Daar ontstaat uiteindelijk het echte concurrentievoordeel.
Niet uit AI alleen.
Maar uit de combinatie van AI, data, context en governance.
Conclusie: bouw niet alleen de intelligentie, bouw ook de werkelijkheid eronder
Er is op dit moment terecht veel enthousiasme over agentic AI. De technologie kan processen fundamenteel veranderen en organisaties in staat stellen werkzaamheden op een compleet andere manier te organiseren.
Maar wie alleen naar de agent kijkt, mist een belangrijk deel van het verhaal.
Een AI-agent moet weten over wie hij het heeft. Hij moet begrijpen waar informatie vandaan komt, welke data betrouwbaar is en hoe verschillende gegevens met elkaar samenhangen.
Dat maakt het datafundament niet minder relevant in het AI-tijdperk.
Het maakt het juist belangrijker dan ooit.
De belangrijkste uitdaging voor organisaties wordt daarom niet alleen het bouwen van intelligente agents, maar het creëren van een informatieomgeving waarin die agents betrouwbaar kunnen opereren.
Want uiteindelijk geldt een eenvoudige regel:
hoe slimmer de agent wordt, hoe beter de werkelijkheid eronder georganiseerd moet zijn.
Dat is waarschijnlijk waar de volgende fase van agentic AI over zal gaan.
Job van den Berg is AI keynote spreker, tech-ondernemer en auteur van vijf boeken over AI. Hij zet wekelijks zelf agents in productie en geeft 150+ keynotes per jaar over AI-agents en agentic commerce.
Topbrein, werkpaard of sprinter? Zo kies je per taak het juiste AI-model en combineer je kwaliteit, snelheid en kosten met slimme orchestratie van AI-agents.
AI kan archiefonderzoek versnellen, maar vult ontbrekende feiten ook overtuigend in. Zo combineer je het juiste model, strakke instructies en kritische controle voor betrouwbaar stamboomonderzoek.
De GPU doet het rekenwerk van het model, de CPU houdt de rest van de agent draaiende. Waarom agentic AI de blik op datacenters verandert, en wat dat betekent voor Intel, AMD en organisaties die agents inzetten.
Wat zijn open weights en closed-source AI-modellen? Ontdek de verschillen en de gevolgen voor kosten, privacy, datacenters en de AI-markt.