Het beste AI-model is niet het beste model voor elke taak
Dat er verschillende AI-modellen zijn, weet inmiddels iedereen. Maar door de bomen zie je het bos niet meer: welk model gebruik je nu wanneer? Wij maakten een handig en eenvoudig spiekbriefje.
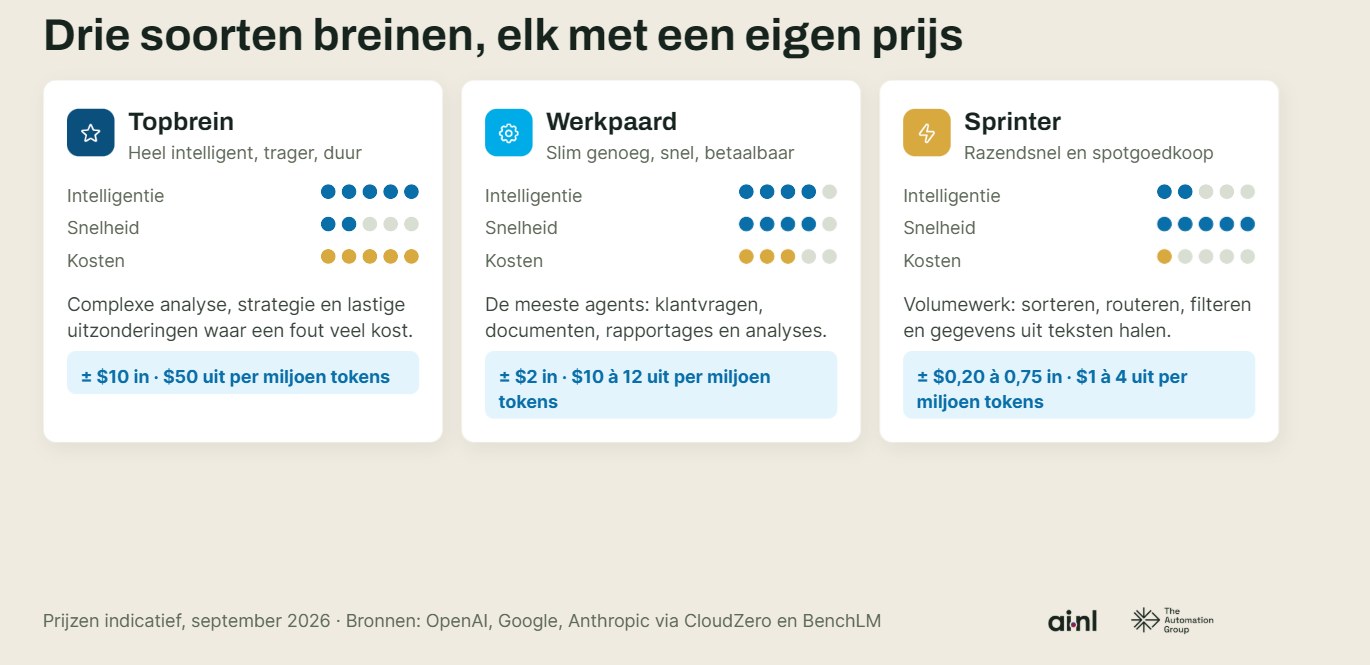
Elke paar maanden verschijnt er weer een nieuw topmodel, met een indrukwekkende benchmark en een nog hogere prijs. De reflex is dan snel gemaakt: als het nieuwste model het slimste is, dan zetten we dat overal in. Zeker bij AI-agents, die tientallen of honderden taken per dag uitvoeren, is dat een dure en onnodige keuze.
In dit artikel leggen we uit waarom, en geven we je een eenvoudige manier om per taak het juiste model te kiezen.
Waarom is dit relevant?
Stel: je wilt vanavond nog een vlucht boeken naar Barcelona. Je vraagt een AI: "Vertrekt er na 19.00 uur nog iets vanaf Schiphol?"
Het meest geavanceerde model geeft eerst een foutloze uitleg over luchtvaartnetwerken, prijsdynamiek, bagageregels en de gemiddelde vertraging op Europese vluchten. Daarna vraagt het om je vertrekdatum, bestemming, budget, handbagage en stoelvoorkeur.
Een eenvoudiger, minder 'statistisch slim' model doet iets minder indrukwekkends, maar wel nuttigs: het zoekt de actuele vertrektijden op en geeft je direct antwoord. Dat tweede model is misschien minder slim op een benchmark, maar voor jou is het op dat moment duidelijk het betere model.
Precies dat gebeurt als je voor elke taak het allernieuwste, slimste AI-model inzet. Het is duurder, het is trager en het doet veel meer dan je nodig hebt. Het beste model is dus niet het beste model voor elke taak. Dat geldt ook als de kosten je niet uitmaken.
De verborgen kosten van altijd het beste model
De prijs per token is maar één kant van het verhaal. Wie overal het zwaarste model inzet, betaalt op vier manieren.
- Geld: een topmodel kost per verwerkte tekst een veelvoud van een sprinter. Bij duizenden taken per dag loopt dat snel op.
- Snelheid: zware modellen denken langer na. Voor een klant die live wacht op een antwoord, of een proces dat honderden stappen achter elkaar doet, telt elke seconde.
- Overkill: een model dat alles uitgebreid onderbouwt, geeft je meer tekst dan je nodig hebt. Dat is zoeken naar het antwoord in een stapel uitleg.
- Onnodige complexiteit: hoe meer een model 'meedenkt', hoe groter de kans dat het de opdracht ruimer interpreteert dan bedoeld. Een duidelijke taak vraagt om een duidelijke uitvoerder, niet om een filosoof.
Het gaat dus niet alleen om besparen. Een goed gekozen, lichter model is voor veel taken ook gewoon de beste oplossing.
Drie soorten breinen
Je kunt alle versies van LLM's grofweg vertalen naar drie soorten breinen.
Het topbrein (denk aan Astra, Fable of Gemini Pro). Heel intelligent, maar trager en duur. Inzetten voor complexe analyse, strategie en lastige uitzonderingen waar een fout veel kost. Alleen als het echt moeilijk is.
Het werkpaard (denk aan Opus, Sonnet of Gemini Flash). Slim genoeg, snel en betaalbaar. Dit is voor de meeste agents het juiste model: klantvragen, documenten, rapportages en analyses. Begin hier.
De sprinter (bijvoorbeeld Haiku, Grok 2-mini of Qwen Turbo). Razendsnel en spotgoedkoop. Voor volumewerk als sorteren, routeren, filteren en gegevens uit teksten halen. Duizend mails categoriseren doe je niet met Einstein.
Topbrein
- Sterk in: Redeneren, afwegen, uitzonderingen, grote context
- Niet inzetten voor: Routinewerk in volume
- Typische taak: Contractrisico beoordelen, strategie-advies, een escalatie die niet in het draaiboek past
Werkpaard
- Sterk in: Goede balans tussen kwaliteit, snelheid en prijs
- Niet inzetten voor: Zeer lastige of risicovolle beslissingen
- Typische taak: Klantvraag beantwoorden, rapport samenvatten, analyse schrijven
Sprinter
- Sterk in: Snelheid, volume, vaste patronen
- Niet inzetten voor: Vage opdrachten waar nuance telt
- Typische taak: Mails categoriseren, tickets routeren, velden uit tekst halen
De vuistregel
Is de taak duidelijk en gaat het om veel volume? Kies dan een licht model. Is de taak vaag en kost een fout veel? Kies dan een zwaarder model.
Stel jezelf bij elke taak drie vragen:
- Is de opdracht helder en steeds van dezelfde vorm? Dan volstaat een sprinter.
- Hoeveel keer per dag gebeurt dit? Hoe hoger het volume, hoe lichter het model.
- Wat kost een fout? Hoe duurder een fout, hoe zwaarder het model, of een mens die meekijkt.
Twijfel je? Begin met het werkpaard. Merk je dat het te vaak fouten maakt, ga dan omhoog. Merk je dat het ruim voldoende is en de taak eenvoudig, ga dan omlaag. Meten is hier beter dan gokken: test dezelfde taak met twee modellen en vergelijk de uitkomst.
Orchestratie is het sleutelwoord
Daarom draait het bij agents om orchestratie. Je bepaalt per taak welk model, met hoeveel intelligentie, op welk moment het werk doet.
Een sprinter pakt de binnenkomende stroom en stuurt door. Het werkpaard handelt het meeste af. Het topbrein komt er alleen bij als het echt nodig is.
Dat scheelt kosten, het gaat sneller en het werkt vaak beter, omdat elk model doet waar het goed in is.
Gebruik het spiekbriefje als startpunt voor je volgende agent of use case.
Voorbeeld: een agent voor binnenkomende klantmail
Neem een agent die de klantmailbox van een webshop afhandelt. Een slimme opzet gebruikt drie lagen.
- De sprinter leest elke binnenkomende mail, bepaalt het type (retour, leverstatus, factuurvraag, klacht) en haalt het ordernummer eruit. Dit is volumewerk met een vast patroon.
- Het werkpaard schrijft het antwoord, op basis van het orderoverzicht en het beleid van de webshop. Dit is het merendeel van de mails.
- Het topbrein pakt alleen de uitzonderingen op: een boze klant met een juridische dreigement, een claim waarbij het beleid tegenstrijdig is, of een zaak waar veel geld mee gemoeid is. Het aantal zaken is klein, maar de fout kost veel.
Het resultaat is dat het merendeel van het werk met goedkope en snelle modellen gebeurt, en het dure model zijn kracht inzet waar die het verschil maakt.
Veelgemaakte fouten
- Alles op het topmodel zetten omdat het 'veilig' voelt. Je betaalt dan voor intelligentie die de taak niet vraagt.
- Alles op de sprinter zetten om te besparen. Bij vage of risicovolle taken krijg je dan fouten die je later duur terugbetaalt.
- Nooit testen. Welk model past, merk je pas als je de uitkomsten naast elkaar legt op jouw eigen data.
- Modelkeuze vastzetten. Modellen veranderen snel. Bouw je agent zo dat je het model per stap kunt omwisselen, zodat je meebeweegt met wat er beter of goedkoper wordt.
- De mens vergeten. Voor taken waar een fout echt pijn doet, is een controlestap soms slimmer dan een zwaarder model.
Zo begin je
Pak je volgende agent of use case en deel het proces op in losse stappen. Geef elke stap een label: sprinter, werkpaard of topbrein. Start met het werkpaard als je twijfelt, schuif het routinewerk door naar de sprinter en bewaar het topbrein voor de momenten waarop een fout echt iets kost.
Het beste model is niet het slimste model. Het is het model dat op dat moment de taak goed, snel en betaalbaar uitvoert.
Job van den Berg is AI keynote spreker, tech-ondernemer en auteur van vijf boeken over AI. Hij zet wekelijks zelf agents in productie en geeft 150+ keynotes per jaar over AI-agents en agentic commerce.
AI kan archiefonderzoek versnellen, maar vult ontbrekende feiten ook overtuigend in. Zo combineer je het juiste model, strakke instructies en kritische controle voor betrouwbaar stamboomonderzoek.
De GPU doet het rekenwerk van het model, de CPU houdt de rest van de agent draaiende. Waarom agentic AI de blik op datacenters verandert, en wat dat betekent voor Intel, AMD en organisaties die agents inzetten.
Wat zijn open weights en closed-source AI-modellen? Ontdek de verschillen en de gevolgen voor kosten, privacy, datacenters en de AI-markt.
Bij EditieNL sprak ik over de vraag of AI een bedreiging kan vormen voor de mens. Over Anthropic-onderzoeker Evan Hubinger, agentic AI, de black box en waarom we sneller bouwen dan we begrijpen.